CSC6001 算法分析速成笔记
1 Asymptotic Analysis 渐近分析
1.1 Pure Math Perspective 纯数学视角
先抛开算法, 从纯数学的角度来看, 渐近符号就是用来描述函数在输入趋近于无穷大时的增长行为.
- 几点注意:
- 为了简单化表述, 我们把 \(\exists n_0, \forall n \ge n_0\) 后的表现称为 eventually 最终 行为.
- 把 \(g \in \mathcal{O}(f)\) 不严谨地记为 \(g = \mathcal{O}(f)\).
- \(g = \mathcal{O}(f)\) 表示 \(g\) 最终不超过 \(f\) 的某个常数倍.
- \(g = \mathcal{o}(f)\) 表示 \(g\) 最终不超过 \(f\) 的任意常数倍.
- \(g = \Omega(f)\) 表示 \(g\) 最终不小于 \(f\) 的某个常数倍.
- \(g = \omega(f)\) 表示 \(g\) 最终不小于 \(f\) 的任意常数倍.
- \(g = \Theta(f)\) 表示 \(g\) 最终与 \(f\) 的增长率相同, 即 \(g = \mathcal{O}(f)\) 且 \(g = \Omega(f)\).
- 不存在 \(g = \theta(f)\) 的关系 (想想为什么).
2 Problems Statements 算法常见问题
对于算法的理解无法脱离例子的数量, 下面列举了常见的算法问题, 先确保弄清每个问题的意图.
- Sorting 排序问题: 给一个 \(n\) 个整数的数组升序排列.
- Shortest Path 最短路径问题: 给定一个 edge-weighted digraph, 求给定起点和终点的最短路径 (一个标量).
- Fibonacci 斐波那契数列问题: 给定一个整数 \(n\), 求它对应的斐波那契数是多少.
- Longest Common Subsequence (LCS) 最长公共子序列问题: 给定两个字符串, 求它们的最长公共子序列.
- Subsequence 子序列: 比如 BDFH 是 ABCDEFGH 的子序列 (可以跳过字符).
- Unbounded Knapsack Problem 无界背包问题: 给定一个容量为 \(W\) 的背包和 \(n\) 个物品, 每个物品有一个重量 \(w_i\) 和价值 \(v_i\), 求最大价值和对应的选法 (每件物品有无限件).
- 0/1 Knapsack Problem: 每件物品只有一件 (只有选/不选, 记为 0/1).
- Activity Selection 活动选择问题: 每一个活动都有固定的开始时间和结束时间 (不是固定 duration), 可能有重叠, 同一时间只能做一个活动, 求一个活动子集使活动的数量最多.
- Scheduling Problem 调度问题: \(n\) 个任务, 每个任务有一个 duration 和 cost (cost 是完成它的时间加上前面做其他任务的时间乘一个单位 cost). 求一个任务顺序使得总 cost 最小.
- Encoding Problem 编码问题: 对于指定文档, 求一个 prefix code 使得总编码长度最小.
- Closest Pair 最近点对问题: 给定 \(n\) 个点的二维坐标, 求距离最近的两个点的坐标.
- Longest Increasing Subsequence (LIS) 最长递增子序列问题: 给定一个整数数组, 求它的最长递增子序列.
- Maximum Increasing Subsequence (MIS) 最大递增子序列问题: 找一只股票的涨幅最大的连续子序列.
- 这个问题等价于求差分数组的一个连续子数组, 使得它的和最大.
- Coin Changing Problem 换零钱问题: 给定价格 \(n\) 和无限的四种面额的硬币 \(\{1, 5, 10, 50\}\), 求最少的硬币数使得总额为 \(n\).
3 Recursion Paradigm 递归
Recursion 是一种设计思想 (paradigm/meta-technique), 不是一种具体的算法.
3.1 MIS 最大递增子序列问题 (股票涨幅最大问题)
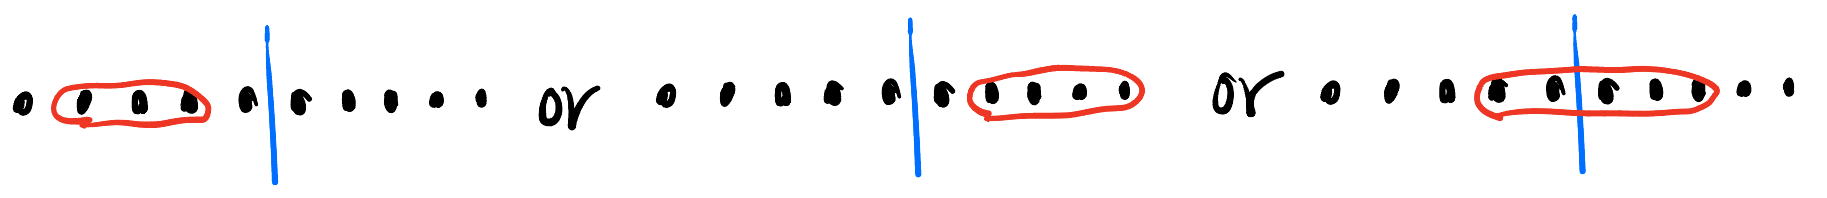
如 Figure 1 所示, 假设原数组被蓝线切成两半, 假设 Figure 1 红色部分即为所求.
- 原问题 \(T(n)\) 分为 3 种情况:
- 红色在左边: 问题成功缩小了规模, 递归求解左半边 (\(T(n/2)\)) 即可.
- 红色在右边: 同上 (\(T(n/2)\)).
- 红色跨越蓝线: 既然已经跨越, 左边从右向左扫描, 右边从左向右扫描 (既然要遍历一遍, 复杂度为 \(\Theta(n)\)), 记录各自的 index 和 sum, 最终的 sum 是两边加起来就好.
- 时间复杂度的递推关系: \[ T(n) = \begin{cases} \mathcal{O}(1), & n = 1 \\ 2T(n/2) + \Theta(n), & n > 1 \end{cases} \]
3.2 Closest Pair 最近点对问题
废话不多说, 三种情况:
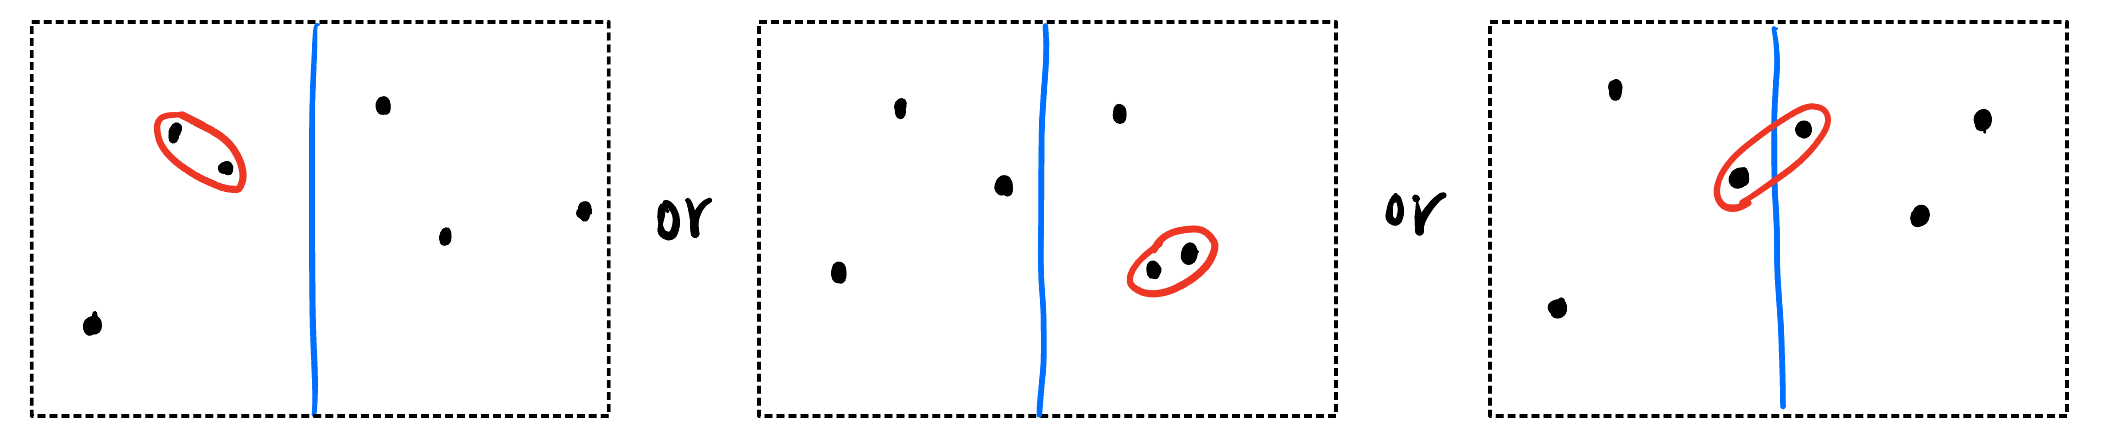
现在讨论如果蓝线跨越点对, 距离最短的两个点应该怎么找. 跟 MIS 不同, 这里如果要 brute force search 的话需要看所有点对, 复杂度为 \(\Theta(n^2)\). 但是直觉上讲我们之需要看蓝线附近的点对就行了. 多附近呢? 假设我们知道左半边和右半边的最短距离分别为 \(d_L\) 和 \(d_R\), 定义 \(\delta := \min(d_L, d_R)\), 我们可以很自信地排除所有绿带外面的点.
绿带内的点呢? 如果还是需要两两看的话还是有可能 \(\mathcal{O}(n^2)\) 的复杂度.
(omitted)
3.3 Unbounded Knapsack 问题
暂时假设对于容量 \(W\) 的背包, 我们只要求最大价值 \(V(W)\), 不需要知道选了哪些物品. 如何构建子问题呢? 如 Figure 3 所示, 随便从背包里拿出一个物品, 假设是 \((w_3, v_3)\), 那么对于另一个容量为 \(W-w_3\) 的背包, 其最优解一定恰好是当前这个容量 \(W\) 的背包剩下的物品配置. 因为假如 \(W-w_3\) 存在另一种价值严格更高的配置的话, 现在 \(W\) 的背包里的最优解就应该是这“另一种配置”. 于是, 我们找到了这个问题的子结构!
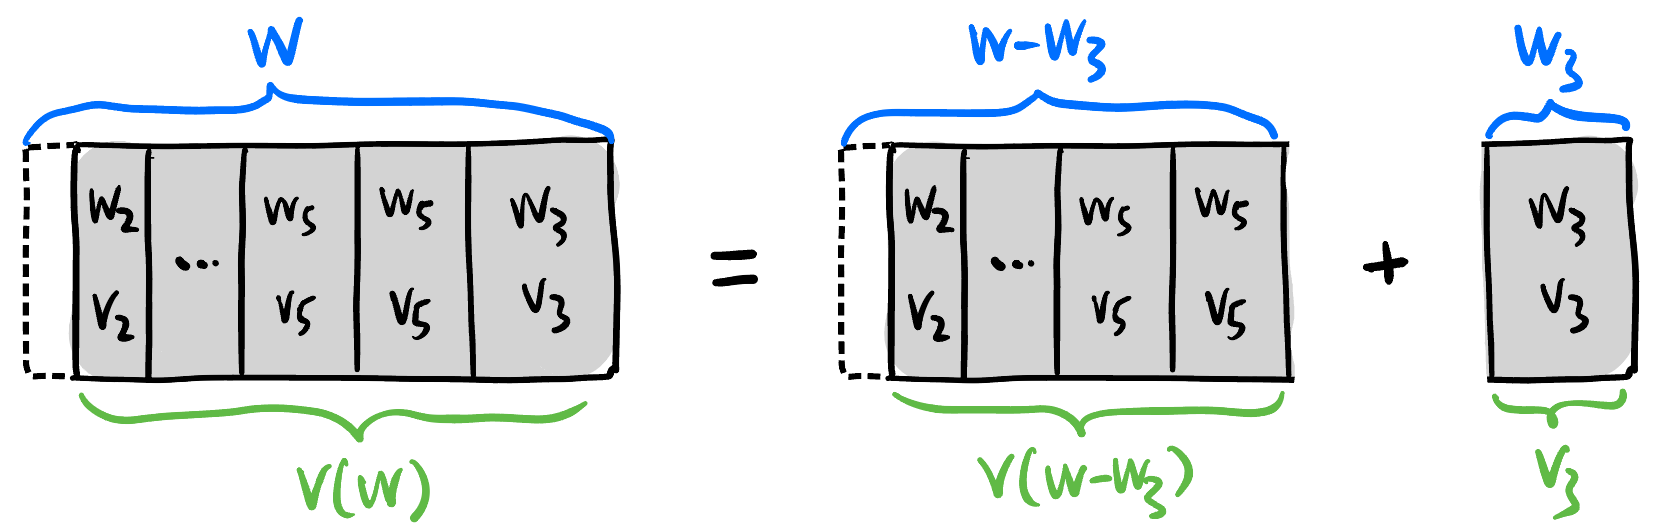
- 但是我们并不知道哪些物品被选中了, 哪些没有. 所以我们遍历每一个物品并取最大值: \[ V(W) = \begin{cases} 0, & \forall w_i, w_i > W \\ \max_i \{V(W-w_i) + v_i\}, & \text{otherwise} \end{cases} \]
3.4 0/1 Knapsack 问题
这个问题跟上面问题的唯一区别就是每件物品只有一件, \(V(W)\) 和 \(V(W-w_i)\) 还有关系吗? 当去掉物品 \(i\) 后, 剩余的问题需要改成“在除取物品 \(i\) 的情况下选择”, 物品的数量都变了, 它不再是一个设定相同的子问题……until 我们引入一个新的参数 \(n\) 来把物品数量也纳入递归! 这样物品的数量不再是一个问题超参而是一个可递归改变的参数. 先假设 \(n\) 代表前 \(n\) 个物品 (看看我们能不能写出自相似的递归式). 我们需要找 \(V(W, n)\) 的子问题.
- 不妨把问题分为下面两种情况:
- 第 \(n\) 个物品在容量为 \(W\) 的背包里. 那相当于从前 \(n-1\) 个物品中选择, 且背包容量为 \(W-w_n\), 最后再加上 \(w_k\): \(V(W, n) = V(W-w_n, n-1) + v_n\)
- 第 \(n\) 个物品不在容量为 \(W\) 的背包里. 既然不在, 那相当于直接从前 \(n-1\) 个物品中选择, 背包容量不变: \(V(W, n) = V(W, n-1)\)
- 综上, 我们有: \[ V(W, n) = \begin{cases} V(W-w_n, n-1) + v_n, & w_n \text{ in bag} \\ V(W, n-1), & w_n \text{ not in bag} \end{cases} \]
- 但是! 上面的分类方法在编程时后面的 if 根本无法判断, 因为我们不知道 \(w_n\) 是否在背包里, 我们需要换一种可判断的分类方法! 我们可以按照 \(w_n\) 是否能放入背包来分类:
- \(w_n > W\): 不能放入背包, 那么 \(V(W, n) = V(W, n-1)\)
- \(w_n \le W\): 可以放入背包, 那么我们就可以选择放入或者不放入, 取最大值: \[ V(W, n) = \max\{V(W-w_n, n-1) + v_n, V(W, n-1)\} \]
- 综上, 我们有: \[ V(W, n) = \begin{cases} V(W, n-1), & w_n > W \\ \max\{V(W-w_n, n-1) + v_n, V(W, n-1)\}, & w_n \le W \end{cases} \]
4 Greedy Paradigm 贪心
Recursion 是一类算法, 如果一个算法, 可以根据当前状态, 直接选一个当前最好的动作, 并把这个决定固定下来, 然后只继续处理这个选择之后剩下的一个子问题, 并得到全局最优的解, 这个算法就被称为 greedy 算法.
如果已知某个问题能用 greedy 算法求解, 一般步骤是:
- 猜一个最优解 (有点难 lol)
- 证明最优解
4.1 Activity Selection 问题
先猜一个最优解: 按照活动结束的时间从左往右挨个选 (当然要跳过冲突的活动), 最后得到的活动集合就是最优解. 换句话说, 我们要证明的命题 \(P(k)\) 是: 存在一个最优解 \(T^*\), 包含 greedy 算法的前1 \(k\) 个选择 (记为 \(\{a_1, a_2, \cdots, a_k\}\)).
1 由于任何一个 valid 的选择都可以从左往右排成一列, 因此这里我们默认集合中元素的书写顺序就是时间顺序.
下面我们用数学归纳法证明这个命题.
\(P(0)\): 当 \(k = 0\) 时, greedy 算法没有选择任何活动, 所以最优解也应该是空集, 命题成立.
假设 \(P(k-1)\) 成立, 即存在一个最优解集 \(T^* \supseteq \{a_1, a_2, \cdots, a_{k-1}\}\). 我们要证明 \(P(k)\) 成立, 即证 \(a_k \in T^*\)? 不一定, 由于最优解不一定唯一, 我们可以证明把 \(T^*\) 中的第 \(k\) 个活动 (记为 \(a_j\)) 替换成 greedy 算法的第 \(k\) 个活动 \(a_k\) 后, 仍然是一个最优解.
其实我们只要证明替换后的选择是 valid 就行了, 因为替换操作不改变活动的数量, 既然 \(T^*\) 是最优解, 那么替换后的选择也一定是最优解.
如何证明合法性呢? 如 Figure 4 所示, 三条蓝线的时间顺序一定是图中的顺序, 所以交换后一定不会冲突, 论证完毕.
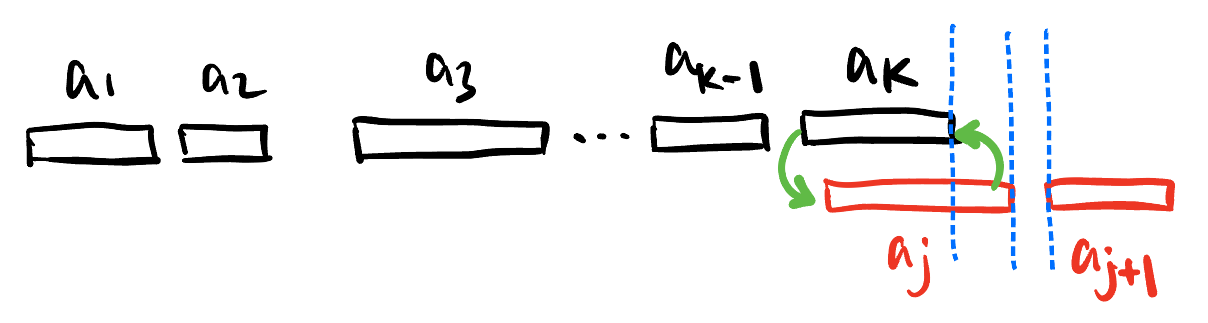
Figure 4: 替换后合法性的论证
4.2 Scheduling Problem 调度问题
先猜一个最优解: 按照活动单位时间 cost \(c_i / t_i\) 降序排列的顺序执行会使总 cost 最小.
这个最优解是如何猜出来的? 我们这样思考:
- 如果两个 job \(A, B\) 时间都是 \(1\), 且 \(c_A > c_B\). 经过简单的推演可以得出我们应该先做 cost 大的 \(A\).
- 如果两个 job \(A, B\) cost 都是 \(1\), 且 \(t_A > t_B\). 经过简单的推演可以得出我们应该先做时间短的 \(B\).
所以我们希望先做 cost 大的和时间短的, 有两种猜想: 降序排列 \(c_i - t_i\) 和 \(c_i / t_i\). 前者可以举出反例 (并且由于量纲的原因也不太可能), 后者看起来是正确的 (很玄学).
下面我们来论证: 假设排列 \(T = \{\cdots, A, B, \cdots\}\) 是一个最优解, 其 cost 为 \(c_T\). 假设交换 \(A,B\) 的位置得到排列 \(T' = \{\cdots, B, A, \cdots\}\), 其 cost 为 \(c_{T'}\). 我们来看 cost 的变化:
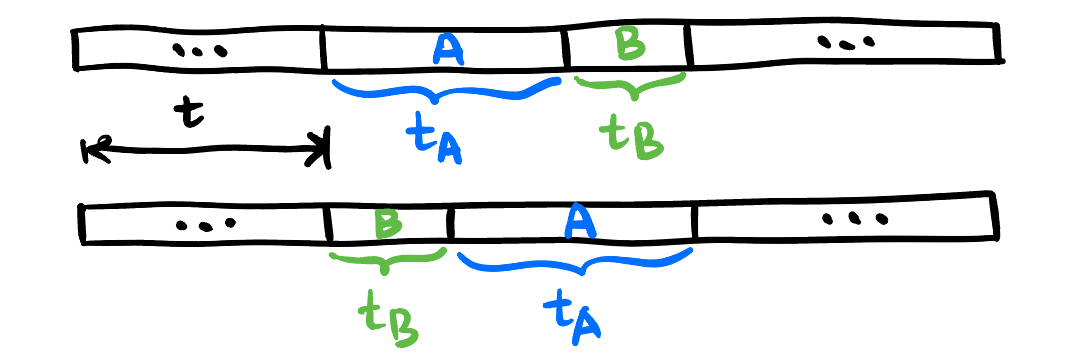
首先交换 \(A,B\) 不会影响其他 job 的 cost, 只会影响 \(A,B\) 的 cost, 从:
\[ c_{AB} = c_A (t + t_A) + c_B (t + t_A + t_B) \]
变成:
\[ c_{BA} = c_B (t + t_B) + c_A (t + t_B + t_A) \]
所以,
\[ \begin{aligned} c_{T'} - c_{T} &= c_{BA} - c_{AB} \\ &= c_B (t + t_B) + c_A (t + t_B + t_A) - c_A (t + t_A) - c_B (t + t_A + t_B) \\ &= c_A t_B - c_B t_A \end{aligned} \]
只要:
\[ \frac{c_A}{t_A} \ge \frac{c_B}{t_B} \]
就有 \(c_{T'} - c_{T} \ge 0\). 说明如果 \(A\) 的单位时间 cost 比 \(B\) 大, 那么从 \(AB\) 顺序改为 \(BA\) 后的 cost 只会不变或者变大, 即排序不能变好. 所以最优的排列只能是满足单位时间 cost 降序 (如果不满足一定可以变成降序排列), QED.
4.3 Huffman Encoding 霍夫曼编码
先记住编码规则: 从小到达排列所有字符的频率, 每次选最小的两个构建出一个新的节点 (频率相加), 重复这个过程.
5 Derive Asymptotic Behavior from Recursion Equation 从递推关系推导渐近行为
本章讨论如何从由 recursion 方法得到的时间复杂度的递推关系式中推导得出算法的渐近行为, 简单来说就是解了个递推数列的通项公式, 只不过我们只关心其渐近行为而不关心准确的表达式.
5.1 Master Theorem 主定理
Master Theorem 给出了形如 \[ T(n) = \begin{cases}\mathcal{O}(1), & n = 1 \\ aT(n/b) + \Theta(n^d), & n > 1 \end{cases}\] 递推关系式的渐近行为的结论. 很简单, 我们慢慢来推:
其中 \(n\) 是问题的规模, \(a\) 是子问题的个数, \(n / b\) 是每个子问题的规模, \(\Theta(n^d)\) 为递归以外进行的计算工作.
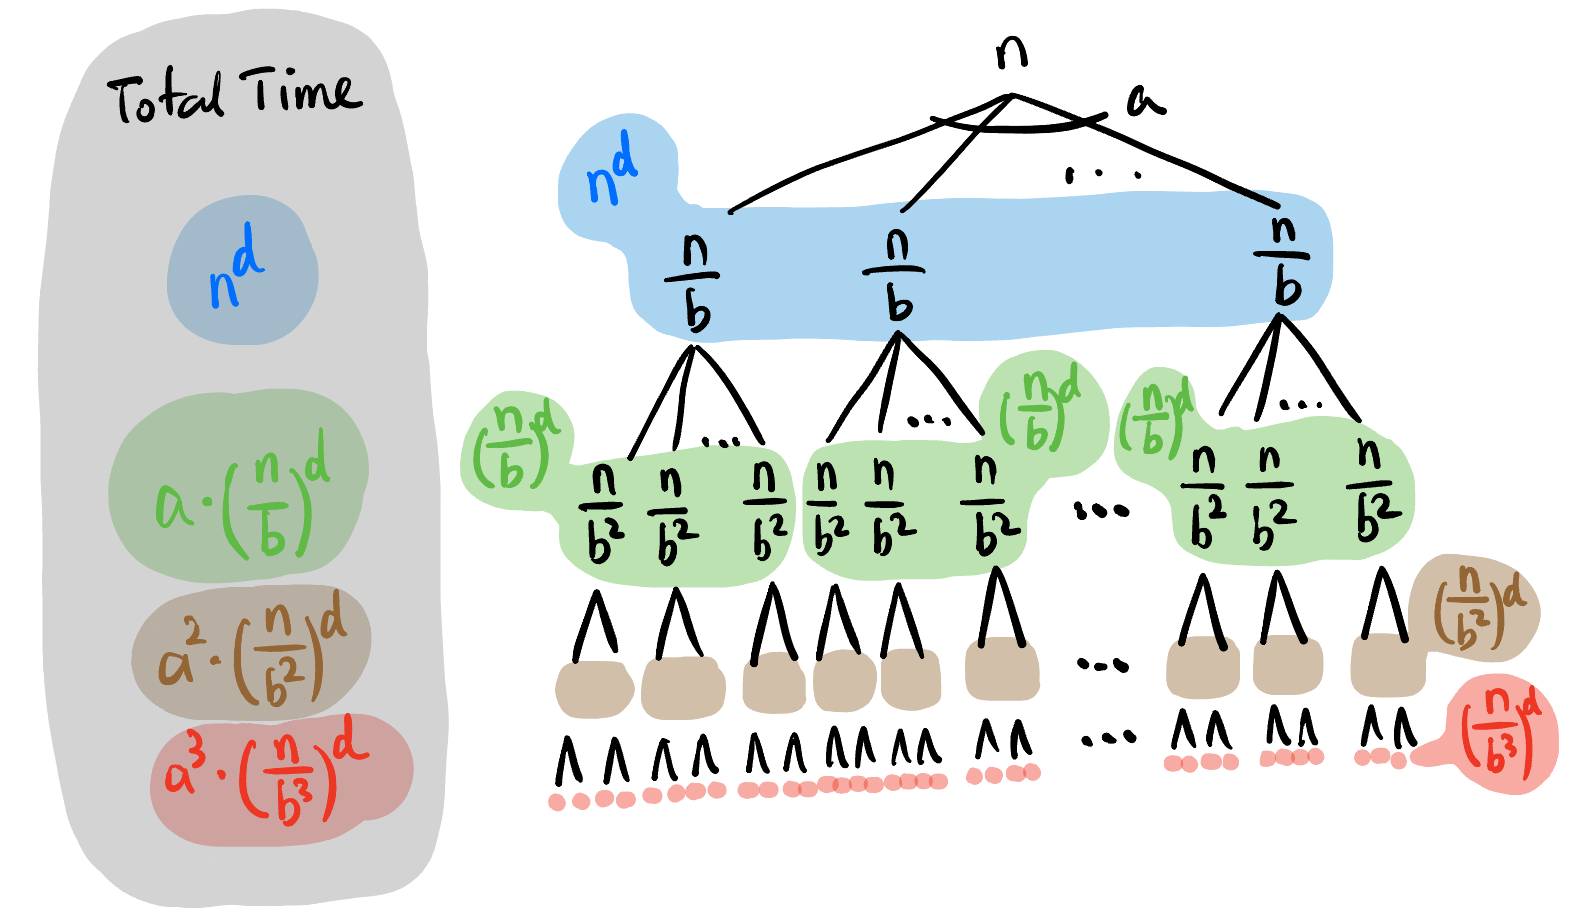
为了解决 \(T(n)\) 的显式表达式, 其实就是把每一次递归的 \(\Theta(n^d)\) 加起来. 每一次递归表现为 Figure 6 的一层, 该层工作量用颜色标记出来了, 第 \(i\) 层的总工作量为: \[ \boxed{n^d \left(\frac{a}{b^d}\right)^i} \tag{1}\]
全部的工作量就是2: \[ \sum_i n^d \left(\frac{a}{b^d}\right)^i \]
2 为什么不用算树上的所有节点的工作量? 先想想看你是如何解递推式 \(A_n = A_{n-1} + 1\) 的, 你会发现你只是把一堆的 \(1\) 加起来, 也就是「额外的工作量」, 其他全部都代入或者说抵消了.
但其实我们并不需要算出这个 sum, 我们只需要它的渐近行为:
- 当 \(a / b^d < 1\) 时, 是一个收敛的几何级数, 第二层到最后一层的和是第一项的常数倍, 所以整个 sum 由第一项主导, 即 \(\boxed{T(n) = \mathcal{O}(n^d)}\).
- 比如 \(T(n) = T(n/2) + n\). (\(a = 1, b = 2, d = 1\))
- 当 \(a / b^d = 1\) 时, 每层的工作量都是 \(n^d\), 共有 \(\log_b n\) 层, 所以 \(\boxed{T(n) = \mathcal{O}(n^d \log n)}\).
- 比如 \(T(n) = 2T(n/2) + n\). (\(a = 2, b = 2, d = 1\))
- 当 \(a / b^d > 1\) 时, 是一个发散的几何级数, 倒过来看就是一个收敛的几何级数, 整个 sum 由最后一层主导, 最后一层每个叶子的工作量是 \(\mathcal{O}(1)\), 树有 \(\log_b n\) 层, 每一层分叉 \(a\) 个, 说明最后有 \(a^{\log_b n} = n^{\log_b a}\) 个叶子, 所以 \(\boxed{T(n) = \mathcal{O}(n^{\log_b a})}\).
- 比如 \(T(n) = 4T(n/2) + n\). (\(a = 4, b = 2, d = 1\)).
- 这样 \(\log_b a > d\), 复杂度比 \(\mathcal{O}(n^d)\) 还高, 属于 Useless recursion lol!
于是:
\[ \boxed{ T(n) = \begin{cases} \mathcal{O}(n^d \log n), & a = b^d \\ \mathcal{O}(n^d), & a < b^d \\ \mathcal{O}(n^{\log_b a}), & a > b^d \end{cases} } \]
5.2 Substitution Method 代入法
(omitted)